まだプログラマーですが何か?

プログラマーネタ中心。たまに作成したウェブサービス関連の話も https://twitter.com/dotnsf

タグ:watson

IBM Watson の比較的新しい API の1つである Watson Data Kit を使ってみました。ちなみにこのブログエントリを書いている 2018/Apr/28 の時点ではこの API はベータ版扱いとなっており、無料で利用できますが、ライトプランから利用することはできないようです。

この API は収集・解析済みのデータにアクセスすることができる API です。具体的にはある地点(緯度&経度)と調査半径(マイル)を指定すると、そのエリア内に含まれる観光名所やアトラクションをまとめて教えてくれる、というものです。特別に明記されているわけではないのですが、使っている限りでの印象として、現時点ではどうやら USA のデータ中心に提供されているようです。

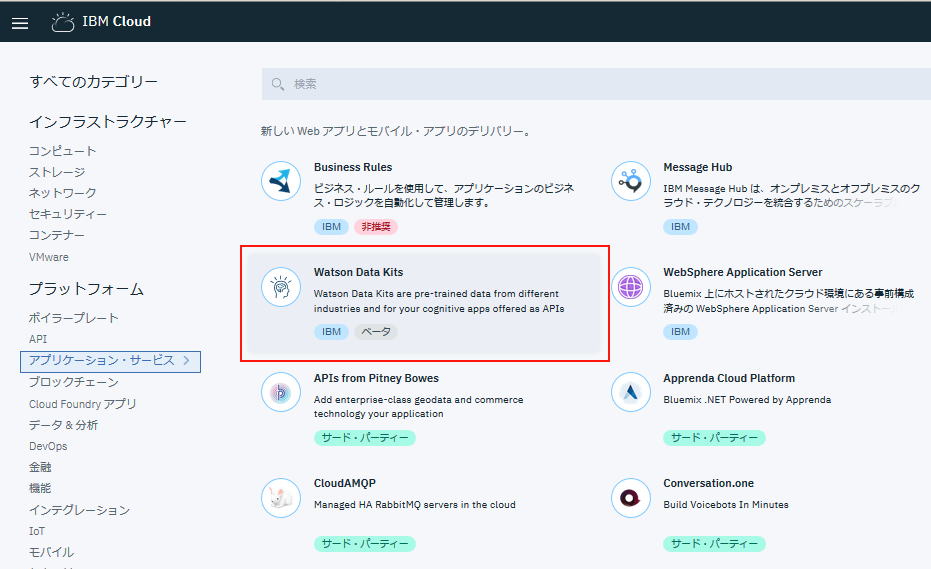
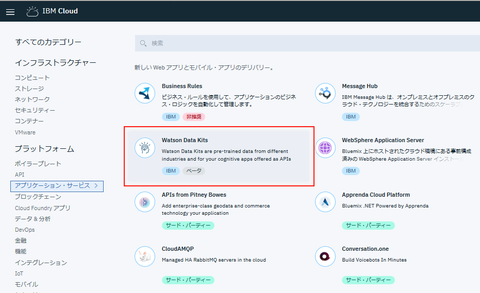
使ってみるには IBM Cloud のダッシュボードから、「アプリケーション・サービス」カテゴリ内にある "Watson Data Kits" を選びます。 「Watson」カテゴリではなく「アプリケーション・サービス」カテゴリ内にあることに注意が必要です:
2018042800


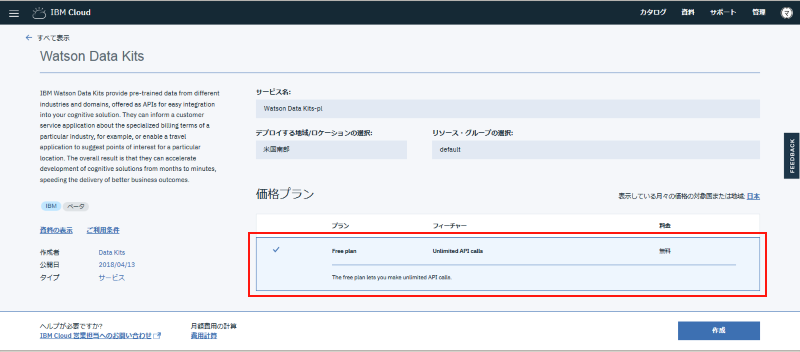
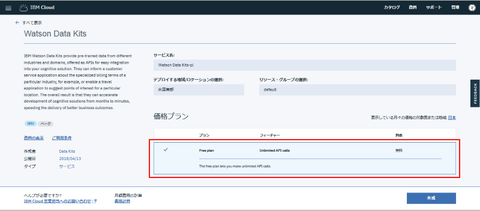
そしてプランを選択してサービスを作成します。現時点では利用制限のない Free plan (無料)のみが提供されているようです:
2018042802


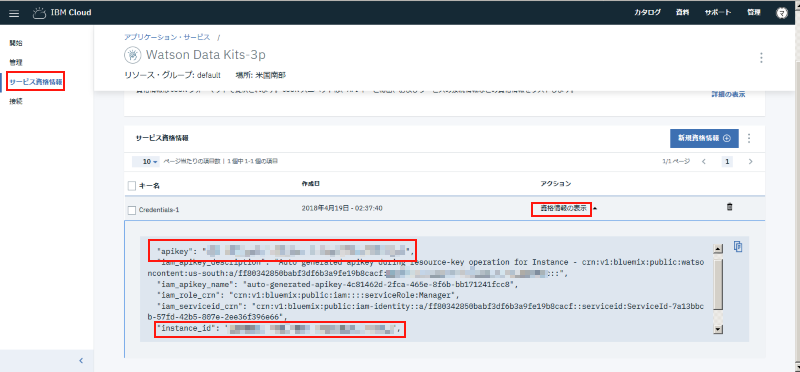
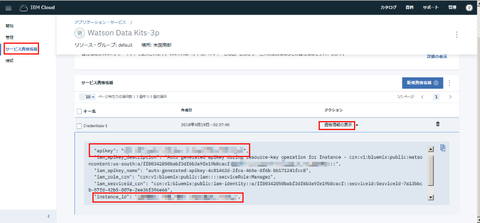
Watson Data Kit サービス作成後、サービス資格情報メニューから資格情報を(必要であれば作成した上で)参照します。この中の apikey と書かれている値と、instance-id と書かれている値が後で必要になります:
2018042803


これらの値を使って、以下のような Node.js のアプリケーションを作ってみました。(apikey) 部分と (instance-id) 部分を上記で取得した値に書き換えると動くようになる、と思います。また以下の例では米国ニューヨーク辺りの位置(北緯 40.73061 度、西経 73.935242 度)と、そこからの半径 5 マイル内のアトラクション( /attractions)を検索し、名称(name)と説明(description)を表示しています:

var request = require( 'request' );

var settings = {
  apikey: '(apikey)',
  instance_id: '(instance id)'
};

// NY
var lat = 40.73061;
var lng = -73.935242;

var radius = 5;  //. 半径 5 マイル

//. アクセストークン取得
var options = {
  url: 'https://iam.bluemix.net/identity/token',
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  form: { grant_type: 'urn:ibm:params:oauth:grant-type:apikey', apikey: settings.apikey },
  json: true
};
request( options, ( err, res, body ) => {
  if( err ){
    console.log( err );
  }else{
    var access_token = body.access_token; //. アクセストークン値

    //. アクセストークンを使って、/attractions API を実行する
    var access_headers = {
      'Authorization': 'Bearer ' + access_token,
      'Instance-ID': settings.instance_id
    };
    var access_options = {
      method: 'GET',
      hostname: 'wck-2.us-south.containers.mybluemix.net',
      port: null,
      uri: settings.apiurl + '/travel/v1/attractions?location=' + lat + ',' + lng + '&radius_miles=' + radius,
      headers: access_headers
    };
    request( access_options, ( err1, res1, body1 ) => {
      if( err1 ){
        console.log( err1 );
      }else{
        body1 = JSON.parse( body1 );
        body1.results.forEach( function( attraction ){
          console.log( attraction.name );
          console.log( ' ' + attraction.description );
        });
      }
    });
  }
});


上記を実行するためにまず apikey 値を使ってアクセストークンを取得し、取得したアクセストークンと instance-id 値を使って /attractions API を実行しています。この辺りの詳しい情報はチュートリアルを参照ください:

https://console.bluemix.net/docs/services/watson-data-kits/index.html#getting-started-tutorial


これを実行するとこんな感じになりました。青字部分が名称(name)で、黒地が説明(description)です:
$ node attractions.js
Calvary Cemetery
 Calvary Cemetery is a Roman Catholic cemetery in Maspeth and Woodside, Queens, in New York City, New York, United States. With about 3 million burials, it has the largest number of interments of any cemetery in the United States; it is also one of the oldest cemeteries in the United States. It covers 365 acres and is owned by the Roman Catholic Archdiocese of New York and managed by the Trustees of St. Patrick's Cathedral.
Calvary Cemetery is divided into four sections, spread across the neighborhoods of Maspeth and Woodside. The oldest, First Calvary, is also called "Old Calvary." The Second, Third and Fourth sections are all considered part of "New Calvary."
* First Calvary Cemetery is located between the Long Island Expressway and Review Avenue. The cemetery's offices are located here, at 49?02 Laurel Hill Boulevard.
* Second Calvary Cemetery is located on the west side of 58th Street between Queens Boulevard and the Brooklyn?Queens Expressway.
* Third Calvary Cemetery is located on the west side of 58th Street between the Long Island Expressway and the Brooklyn?Queens Expressway.
* Fourth Calvary Cemetery is located on the west side of 58th Street between the Long Island Expressway and 55th Avenue.
McCarren Park
 McCarren Park is a public park in Brooklyn, New York City. It is located in Greenpoint, Brooklyn and is bordered by Nassau Avenue, Bayard Street, Lorimer Street and North 12th Street. It is operated by the New York City Department of Parks and Recreation. Opened in 1906 and originally named Greenpoint Park, the park was renamed McCarren Park in 1909 after State Senator Patrick H. McCarren who began work as a cooper at Williamsburg sugar refineries and eventually became the Democratic boss of Brooklyn. The park is a popular destination for recreational softball, volleyball, soccer, handball, and other games. It is also used for sunbathing and dog-walking. In late 2004, the park's track was resurfaced and has been a popular destination for running enthusiasts.
Events on the baseball fields of McCarren Park include members of the punk and indie communities gathering to participate in league-controlled kickball tournaments. For several years, the baseball fields have hosted tournament play for the Hasidim; weekend afternoons provide T-ball and softball games for organized area youth groups; Latino families and friends often utilize the fields to play soccer and volleyball into the late hours of the night. Since June 2003, McCarren Park has hosted SummerScreen in McCarren Park, and The Renegade Craft Fair, a DIY event. The fair attracts artists and creative types, featuring a wide range of merchandise such as reconstructed clothing, comic books, tote bags and other handmade goods.
Pulaski Bridge
 The Pulaski Bridge in New York City connects Long Island City in Queens to Greenpoint in Brooklyn over Newtown Creek. It was named after Polish military commander and American Revolutionary War fighter Kazimierz Pu?aski because of the large Polish-American population in Greenpoint. It connects 11th Street in Queens to McGuinness Boulevard (formerly Oakland Street) in Brooklyn.
5 Pointz
 5 Pointz: The Institute of Higher Burnin' or 5Pointz Aerosol Art Center, Inc., mainly referred to as simply 5 Pointz or 5Pointz, was an American mural space at 45?46 Davis Street in Long Island City, Queens, New York City. When it opened in 1892, it housed the Neptune Meter factory, which built water meters.
   :
   :

位置情報サービスに対して、その周辺のアトラクションやキーワードとなる付加情報を加えることができるようになる、面白い API だと感じました。


IBM Watson から提供されている Visual Recognition(画像認識) API の1つで、ずっとベータ版として提供されていた Similarity Search (類似画像検索)API が正式公開となる前にサービス終了となりました:
Visual Recognition API – Similarity Search Update


非常に簡単に使うことができて、機能も便利で、ベータ版と知りつつ自分もいくつかのプロダクトの中で使ったり、そのサービスをブログやイベント等で紹介したりもしていました。詳しい経緯はわかりませんが、サービスが終了になったことは非常に残念でした。

実は以前にも同じようなことがありました。いわゆる「トレードオフ分析」を行う機能を API として提供していた Watson Tradeoff Analytics API は 2017/05/11 を以ってサービスの追加ができなくなりました(作成済みのサービスは 2018/04 まで使えます)。この API はちょうど自分がこの分析手法を勉強し始めた頃にサービス終了がアナウンスされ、とても残念でした。

この API に関してはちょうどトレードオフ分析を勉強しはじめた当初だったこともあり、自分でもトレードオフアルゴリズムを理解し始めた頃でもありました。で、こんな互換 API を作って公開したのでした:
Yet Another Watson Tradeoff Analytics API


さて話を元に戻して今回の Similarity Search API のサービス終了です。これも非常に残念なことでした。トレードオフ分析の時と異なるのは自分が画像検索アルゴリズムについて勉強していたわけではなく、互換 API を作るにはちとハードルが高かったということでした。

が、調べてみると画像検索にはいくつかの考え方やアルゴリズム、それらごとの向き/不向きがあって、比較的簡単に実現する方法もないわけではない、ということがわかりました。その1つがカラーヒストグラムを使った方法でした:
類似画像検索とカラーヒストグラム


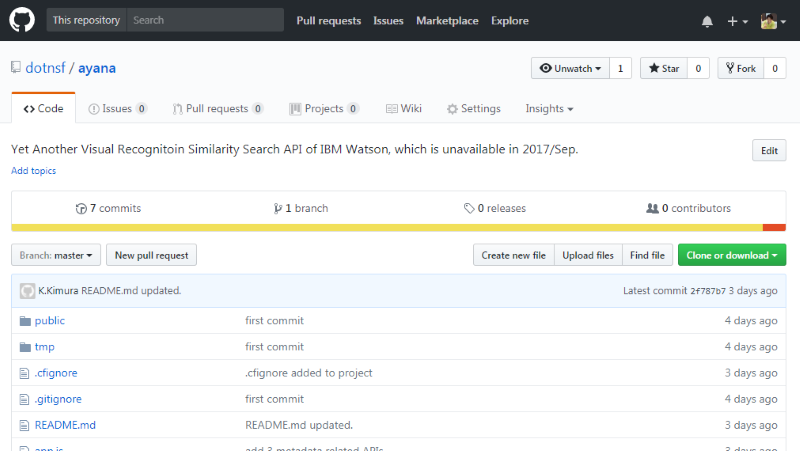
オリジナルの Similarity Search API がこのアルゴリズムを使っていたかどうかは分からない(おそらく使っていない)のですが、とりあえずこのアルゴリズムによって「画像を学習する」&「学習した画像の中から類似した画像を見つける」という最低限必要な機能は実装できそうだ、と思えるようになりました。というわけで今回も互換 API の開発に挑戦してみたのでした。そしてとりあえず出来上がったものをオープンソース化したのがこちらです:
YASS(Yet Another Similarity Search)

2017092400


実装の対象としたのは Watson API Explorer の Visual Recognition API のページを参考に "Collections" カテゴリと "collection images" カテゴリにある全 12 API 、そしてオリジナルにはなかった「学習画像のバイナリを取得する API 」を合わせた 13 API です。オリジナル API のパラメータについては元のものとほぼ互換性を付けたつもりです。また新しい API のパラメータは URL 部分以外にないので特に説明は不要と思っています。なお「ほぼ互換性」という表現を使いましたが、互換性のない箇所は以下のとおりです:
  • オリジナル API の実行時に指定が必要だった API Key を廃止しました。実行時に API Key の指定は不要です。代わりに(必要であれば)Basic 認証をかけることができるようにしました。
  • オリジナル API の実行時に指定が必要だった version パラメータを廃止しました。実行時に version の指定は不要です。正確には version = '2016-05-20' の仕様に従ったものを実装しています。
  • オリジナル API の制限事項であった「1コレクションに対して 1,000,000 画像まで」という制約はありません。ただし画像バイナリごと Cloudant に格納されるため、Cloudant の容量にはお気をつけください。
  • 学習させた画像のバイナリ(画像そのもの)を取得するための API : GET /v3/collections/{collection_id}/images/{image_id}/binary を新たに追加しました。collection_id と image_id を指定して実行すると Content-Type と合わせて画像バイナリが API サーバーから返されます。
  • API 実行後の HTTP レスポンスには status という属性を含めるようにしました(このため、実行結果のフォーマットには互換性がありません)。status = true の場合は成功、false の場合はなんらかのエラーが発生したことを意味しています。

【前提環境】
この互換 API は Node.js で記述されています。従って API サーバーには Node.js のランタイム(と npm)がインストールされている必要があります。また画像や検索に必要な情報は Cloudant データベースに格納されます。2017/Sep/24 現在の仕様では IBM Bluemix 上の Cloudant を使う前提で記述されているため、IBM Bluemix のアカウントを取得して、Cloudant サービスを1つインスタンス化し、その username と password を用意してください。


【インストール方法】
(1) 上記サイトから git clone するか、zip download &展開して、ソースコードを取得します。
(2) ソースコードの settings.js を編集します(青字はコメント。最低限編集が必要になるのは上2つ):
exports.cloudant_username = '(Cloudant Username)';  // Cloudant の username(必須)
exports.cloudant_password = '(Cloudant Password)';  // Cloudant の password(必須)
exports.cloudant_db_prefix = 'yass_';               // Cloudant に作成するデータベース名の prefix(必須だが変更しなくてもよい)
exports.basic_username = 'username';                // Basic 認証をかける場合の username(''にした場合は Basic 認証なし)
exports.basic_password = 'password';                // Basic 認証をかける場合の password(''にした場合は Basic 認証なし)
exports.api_base_path = '/v3';                      // API の基本パス(''でもよいし、変更してもしなくても良い)
(3) npm install を実行
例) $ npm install

(4) Node.js で app.js を実行
例) $ node app.js

(5) curl やアプリケーションから API を利用
例) $ curl -XGET 'http://localhost:6001/v3/collections'


【システム構成】
Similarity Search API の "Collection" に相当する部分を「Cloudant のデータベース」に、画像データに相当する部分を「Cloudant のドキュメント」にみなして格納するようにしました。ドキュメントには attachment として画像ファイルそのものを格納すると同時に、類似検索ができるよう正規化されたカラーヒストグラム情報や、画像データの metadata を合わせて格納するようにしています:
2017092401


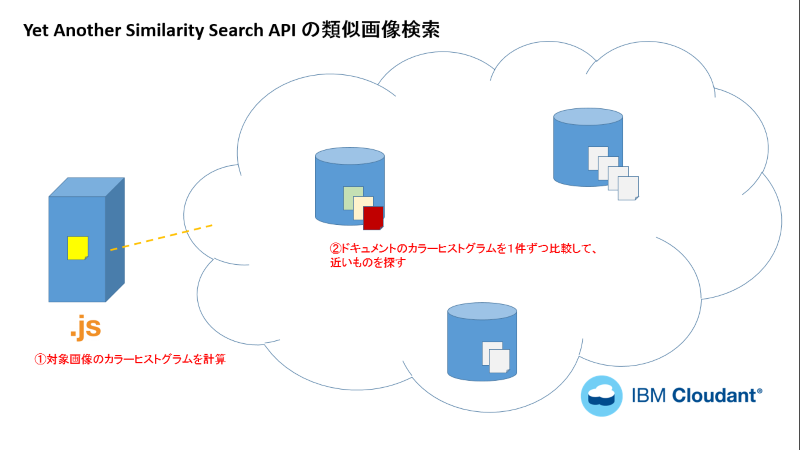
類似検索 API(POST /v3/collections/{collection_id}/find_similar)を実行した時の挙動はまず Collection から全画像を取り出し(つまり Collection に該当する Cloudant データベースから全ドキュメントを取り出し)、カラーヒストグラム情報を1つずつ取り出しては色の類似性を調べて、その上位何件かを返すというアルゴリズムにしています。必ずしも効率のよい検索方法ではないと理解していますが、カラーヒストグラムの比較を効率よく行う方法が思いついていないので、現状はこの方法にしています:
2017092402


【所感】
カラーヒストグラムアルゴリズムを採用したこの互換 API の検索精度はオリジナルのものとは同じではない可能性が高いと思っています(色が重要、どちらかというとイラストよりも写真の類似性に向いている、など)。あまり期待通りでなかったとしてもオープンソース化されているので該当部分のアルゴリズムを変更する、という方法もあると思っています(ちなみに MIT ライセンスで公開してます)。

あと、IBM Watson の互換 API を作ったのは今回が2回目ですが、このように「はじめから仕様が決まっている(仕様が変わらないことも決まっている) API を作る」のは楽です。ある程度、仕様として完成されているが故の安心感もありますし、何度も使っていた API なので動作確認も楽でした。実際、今回の互換 API は休暇を利用して(学習部分も含めて)ほぼ3日で作り上げました(「3日で作れる程度のアルゴリズム実装」と言えなくもないと思います)。


こちらの続きです。以下の紹介はこちらの中で書かれた作業を前提としているので、実際に試してみたい方はまずこちらを参照ください:
Watson Workspace と Zoom を連携する


Watson Workspace に追加した Zoom のチャットボット "Zoom.ai" を使って、第三者との会議の調整を依頼した時の様子を紹介します:
2017050301


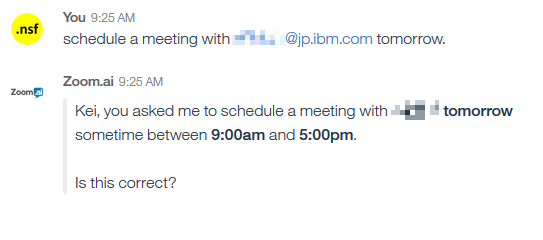
この Zoom.ai 機能を有効にしたスペースの中で(誰にともなく)"schedule a meeting with (メールアドレス) tomorrow."((メールアドレス)さんと明日の会議を予定してくれ)と打ち込みます。すると、Zoom.ai がこのメッセージに反応し、"you asked me to schedule a meeting with (メールアドレス) tomorrow sometime between 9:00am and 5:00pm. Is this correct?"((相手の名前)さんと明日の 09:00AM から 05:00PM までのどこかで会議を調整すればよろしいですね?)と聞いてきました。前回の作業でアドレス帳を共有していたので、メールアドレスから名前を引いてきたわけか、なかなかわかってるね:
2017050211

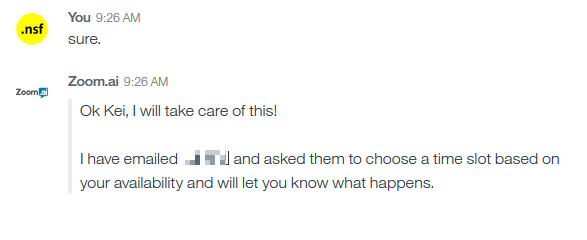
というわけで "Sure"(そうだよ)と返事をすると、"I have emailed (相手の名前), and asked them to choose a time slot based on your availability and will let you know what happens."((相手の名前)さんにメールして、あなたのスケジュールの空きに合わせた日時での選択肢といっしょに打ち合わせの候補日時を選ぶよう伝えておきました。どうなるか、しばらくお待ち下さい)だそうです。あ、もう問答無用でメールしちゃうのね。。 (^^;:
2017050212


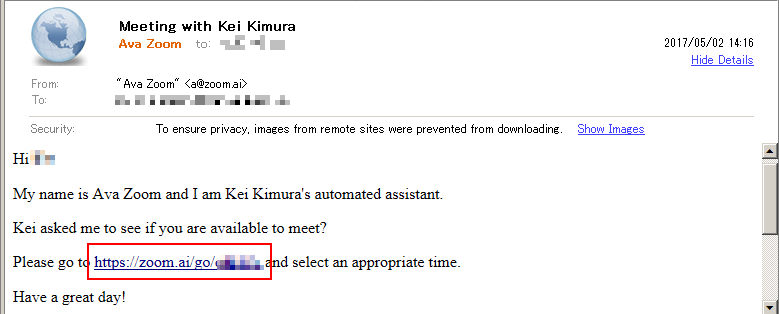
その頃、その相手の人には(僕があなたと打ち合わせしたがっている、という内容の)このようなメールが届いていました。で、メールに書かれたリンクをクリックすると・・・:
2017050201


僕の顔写真と打ち合わせ調整の画面が表示されます。で、場所は相手に選ばせて、時間帯は僕の予定がない、いくつかの候補が表示されていて、この中から選択できるようになっています。日時のタイムゾーンは必要に応じて変更できます(デフォルトは Asia/Tokyo でした):
2017050202


で、この人は場所に「俺の家」、時刻は 07:30AM-08:30AM の早朝会議を選択したことにします。Google カレンダーに同期、にもチェックしました。で "Confirm" ボタン:
2017050203


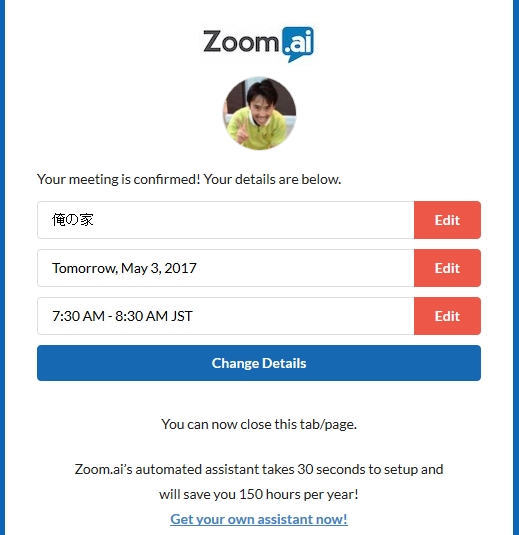
すると、この人の画面には選択した内容が確認の意味で表示されます:
2017050204


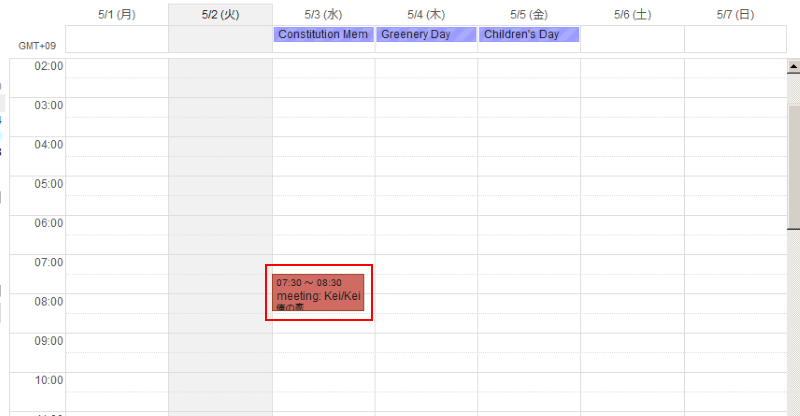
同時に、この人の Google カレンダーにはこの会議がセットされました:
2017050205


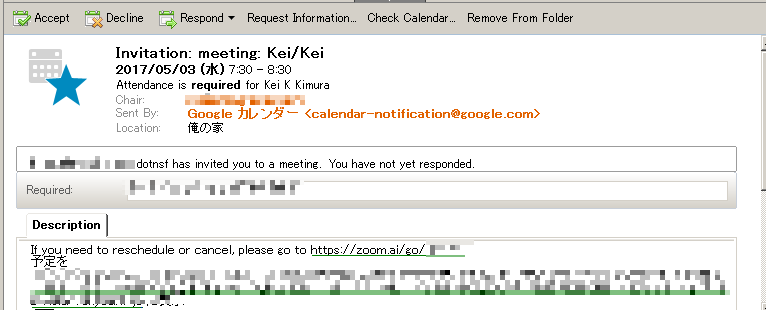
その頃、元々の依頼をした僕の所にはスケジュール予約のメールが届いていました。画面はノーツですが、カレンダー(iCal)対応のメーラー環境であれば、このようにカレンダーメールとして届きます。これを "Accept" すれば、この予定が自分のカレンダーにも反映され、相手には「了承」メールが届きます:
2017050206


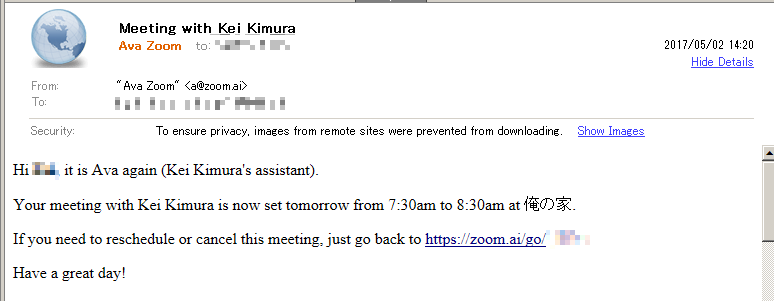
同時にこんな確認メールも届いていました。これで双方にとって都合のいい時間を選んだ上での会議日程が調整できたことになります:
2017050207


とまあ、こんな感じ。会議を依頼した僕は Zoom.ai にその旨を伝えただけで、Zoom.ai は(共有済みの)僕のスケジューラーを確認した上で空き時間帯からいくつかの候補と併せて相手にメールで送り、相手が時間帯を選んだら双方に会議招集の確認メールを送る、という機能を代行してくれたことになります。そしていざ会議が始まる段階になったら、決めた場所に行ってもいいし、Zoom が提供する機能でウェブ会議を行うこともできる、ということになりますね。確かに会議の日時調整は面倒な作業なので、そこを最小限代行してくれてることになります。

この Zoom.ai はまだ英語でしか動かないし、Watson Workspace も(まだプレビュー版ですが)日本語が使える機能があったりなかったりするので、ここで紹介した機能が日本語でできるようになるまではまだしばらくかかるかもしれません。ただ、それでも近未来的な機能が実際に使えている場面を目の当たりにするのは刺激的です。


Zoom というアメリカ生まれの Web 会議サービスがあります:
2017050208


(自信ないですが、日本語公式ページはここかな? 一応日本語マニュアル類は入手できます)
http://zoom-japan.net/


Zoom の特徴は主催者がアカウントを持っていると参加者は URL だけで参加できるとか、簡単に録画できるとか、参加者を仮想の小部屋に分けて分科会を開けるとか、いろいろ便利そうな機能が搭載されているようです。

この Zoom 、昨年末に IBM Watson Workspace とのビデオ会議統合が発表されていました:
Zoom Provides Video Meeting Integration for IBM Watson Workspace

2017050301


IBM の新しいリアルタイム協業ツール Watson Workspace (現在はプレビュー版)に、その場でビデオ会議を行えるような機能を提供する、という発表でした。この時点では具体的な製品や機能に関する発表はありませんでした。

その Zoom が、コグニティブエンジンを搭載したチャット機能を(実際に動かすことのできる)Watson Workspace の拡張アプリケーションとしても提供していたことを最近知りました(苦笑)。プレビュー製品に対する発表とは攻めてますね~:
Zoom Showcases IBM Watson Workspace Integration at IBM Connect


当初の「ビデオ会議を行える機能を提供する」ことに加えて、なかなか面白いコンシェルジュ機能が搭載されていたので、試しにちょこっと使ってみました。Watson Workspace 自体がまだ正式版ではなく、一部の人しかアカウントをお持ちでないかもしれませんが、その雰囲気だけでも伝わることを目指して紹介します。


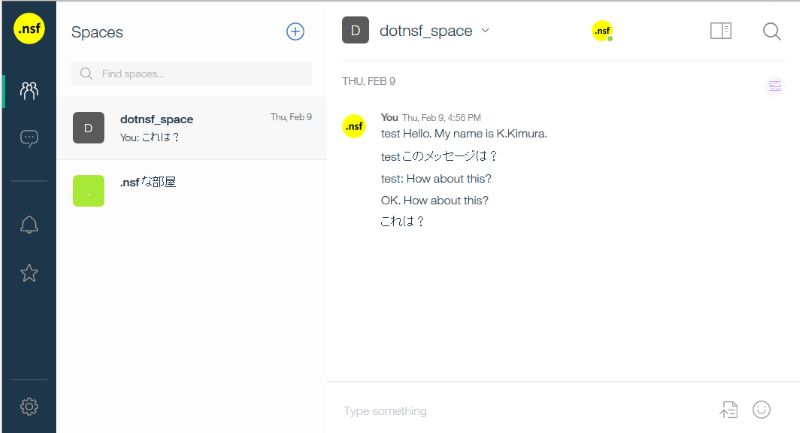
まず、こちらが Watson Workspace の画面です。これ自体は Slack 的なリアルタイムメッセージ共有ものをイメージしていただけるとわかりやすいかなあ。。
2017050201


そしてこちらが今回紹介する Zoom on IBM Watson Workspace です。Watson Workspace のアカウントをお持ちであれば、このページから "Add to Watson Workspace" と書かれた赤いボタンを押して拡張機能を有効にすることも可能です:
2017050202


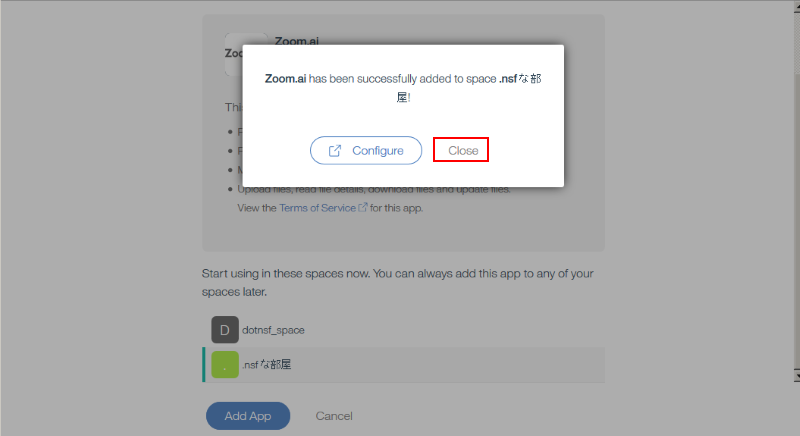
"Zoom.ai" と呼ばれる拡張機能の設定画面です。この拡張機能を有効にするスペースを1つ選べ、みたいなことを言われますが(ここで指定したスペースにはうまく反映できなかったので、詳しくは後述)適当に1つ選んで "Add App" ボタンをクリックします:
2017050203


「正しく追加されました」みたいなメッセージが表示されます。ここでは Close ボタンをクリック:
2017050204


先程指定したスペースに以下で紹介する設定を加えてもうまく有効にできなかったので、この Zoom.ai 専用のスペースを1つ作成します:
2017050205


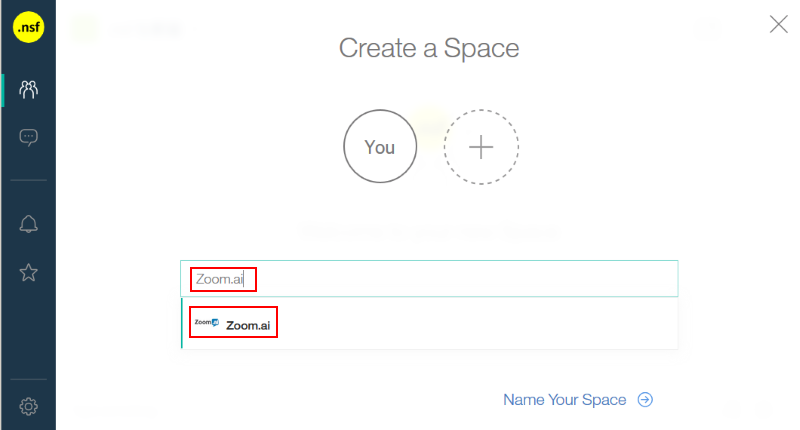
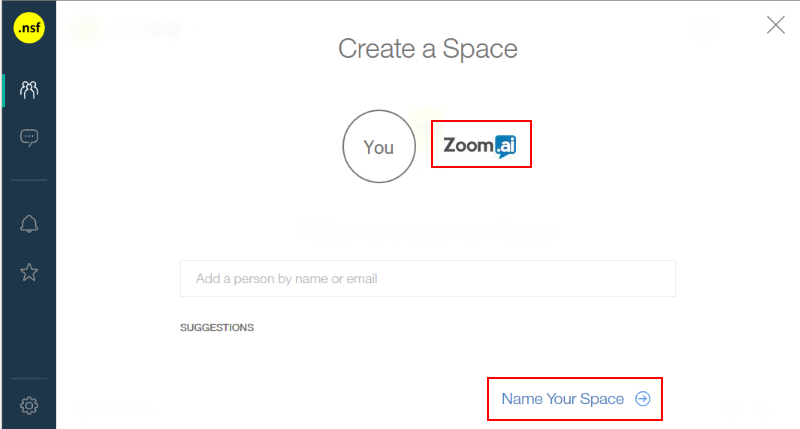
まず、このスペースのメンバーとして Zoom.ai を追加します。"Zoom.ai" と入力すると、それっぽい人が見つかるので、選びます:
2017050206


Zoom.ai さんがスペースのメンバーに追加されました。続けて "Name Your Space" をクリック:
2017050207


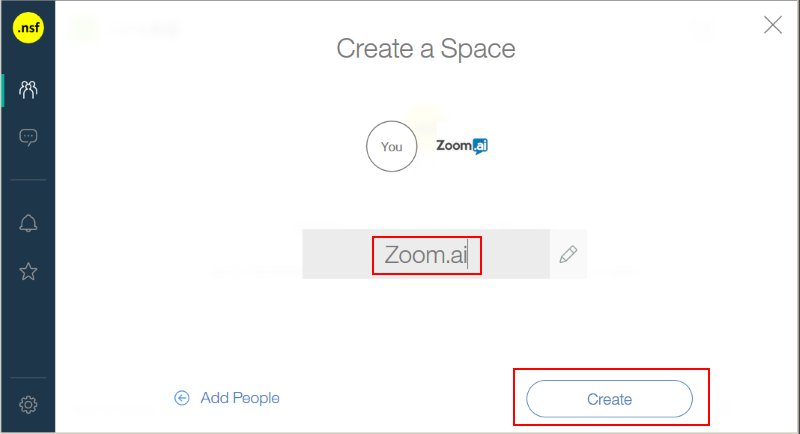
スペースの名前を指定します。ここでは "Zoom.ai" と指定しました。最後に "Create" ボタンをクリックします:
2017050208


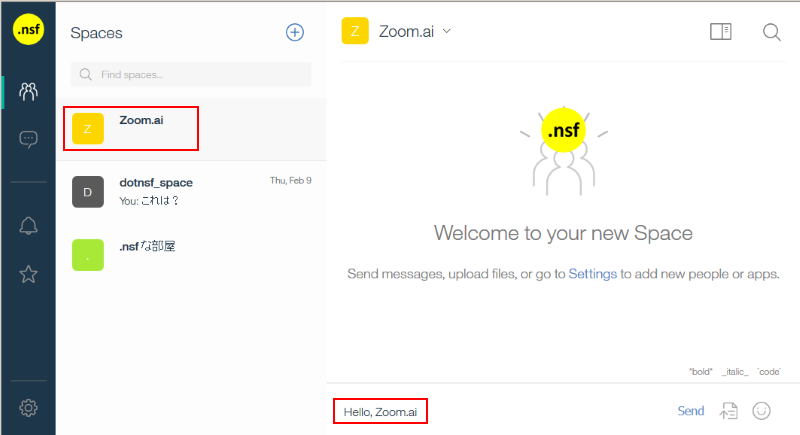
Zoom.ai さんがメンバーに含まれた "Zoom.ai" スペースが追加されました。これを選んで、さっそく何か独り言を書いてみましょう。"Hello, Zoom.ai" と入力しています:
2017050209


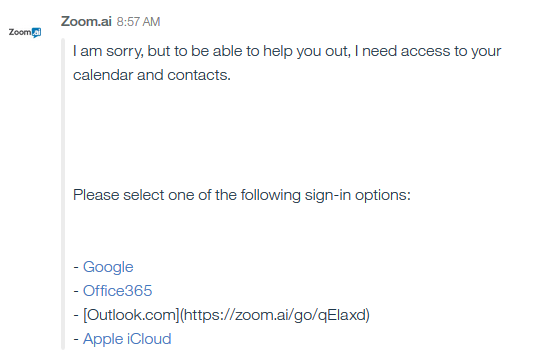
すると、いきなり Zoom.ai がこの独り言に反応します! ・・・ただよく見ると「アクセス権が足りない」とか言ってますね。。
2017050210


スケジュールとアドレス帳の中身を知りたいようです。仕方ないな・・・というわけで、僕は "Google" をクリックして、GMail のカレンダーとアドレス帳をこいつに共有することにしました(試していませんが、Office365 や Apple iCloud にも対応しているようです。ノーツは・・・):
2017050201


で、Google の OAuth 認可の画面に移動します。「許可」をクリック:
2017050202


「セットアップ完了」です。この画面は閉じてもOK:
2017050203


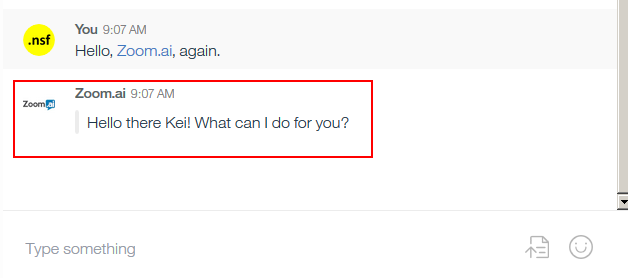
改めて元のスペースに戻り、"Hello, Zoom.ai, again." と挨拶してみました。すると "Hello there Kei! What can I do for you?"(ハロー、けい。何かお手伝いできることある?)と聞いてきました。ほほー・・・:
2017050204


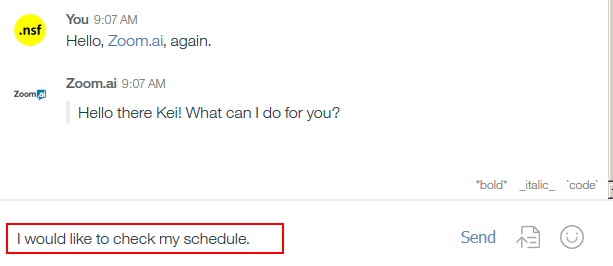
さっきカレンダー共有したから俺の予定知ってるはずだよな? というわけで、"I would like to check my schedule."(俺のスケジュールを教えてくれい)と偉そうに聞いてみました。はたして理解してくれるかなあ:
2017050205


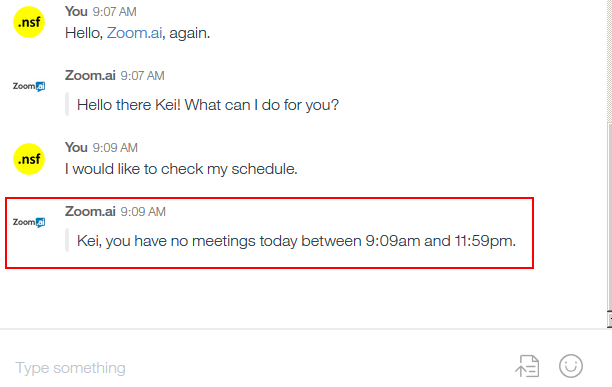
・・・なんと、"you have no meetings today between 9:09am and 11:59pm."(今日は 09:09AM から 11:59PM まで何の予定もないよ)との返事が。ちなみに 09:09PM はこの質問を聞いた時刻です。で、実際 Google カレンダーにはこの日時の予定なし。ほう、なかなかやるな!:
2017050206


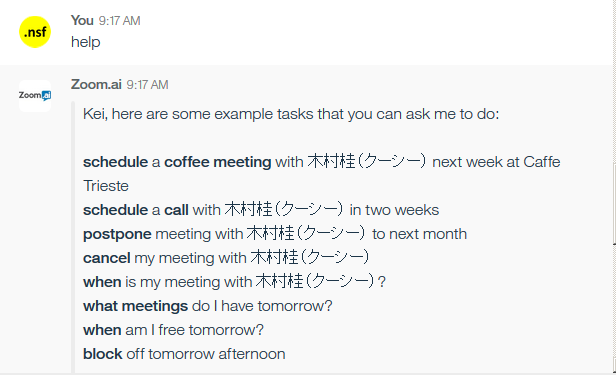
・・・他にはどんなこと聞けるんだろう? というわけで "help"(苦笑):
2017050207
 ↑前職の会社の名前が出てますが気にしないでね(アドレス帳にそう登録してあったので)。


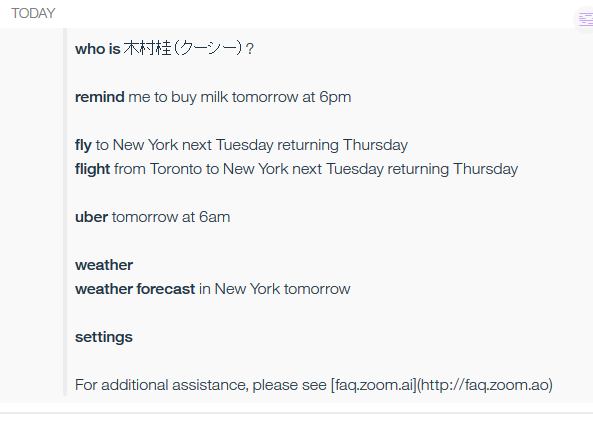
なるほど、スケジュール確認したり、キャンセルしたり、あと Uber 呼んだり、天気確認したりもできそうね。。
2017050208


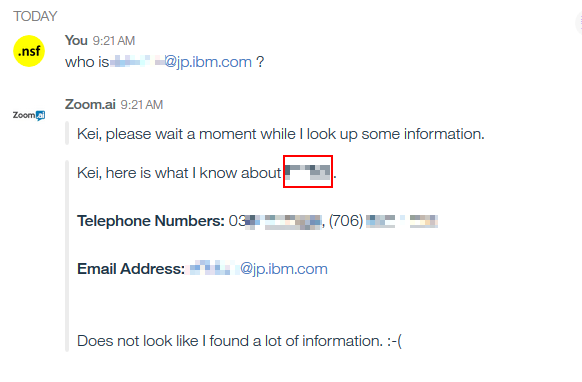
試しにメールアドレスを指定して、"who is XXXX"(XXXX って誰?)と聞いてみると、共有を許可したアドレス帳の情報を元に名前や電話番号などの情報を調べて、返事を返してくれます:
2017050209


また "weather forecast in Tokyo tomorrow."(明日の東京の天気は?)と聞くと天気予報情報を返してくれました:
2017050210


と、こんな感じでとりあえず Zoom.ai とチャットできるところまでは確認できました。ところで、もともと Zoom は Web 会議サービスの大手であり、Watson Workspace にウェブ会議機能を提供する、という発表でした。次回はこのチャット機能を使って別の人との会議を調整する様子を紹介する予定です。


(2017/May/05 追記)続きはこちら


IBM ワトソンなどの各種コグニティブエンジンを使う際に、重要なのは学習データだと思っています。

要はコグニティブエンジンを使って問い合わせを行うわけですが、その問い合わせする前に何らかの学習をする必要があり、そこで何をどれだけ学習させたかによって問い合わせの精度が変わってくるからです。

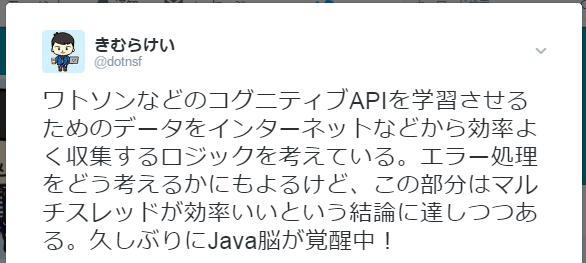
で、先日こんなツイートをしました:
2017022601

https://twitter.com/dotnsf/status/834959690803007488


↑は、その学習データを何らかの方法で集める際に、(非同期処理で集めるのではなく)マルチスレッド処理がいいのではないか、と思ってつぶやいたのでした。このことをもう少し詳しく紹介しようと思います。なお、あくまで特定条件下での個人見解なので他の人の意見も聞いてみたいと思ってます。

やろうと思っているのは、大まかにはこんな内容です:
  1. あらかじめ用意したインターネット上の URL のリストから、その HTML を取得して学習データにしたい
  2. この「リスト」が大量にあるケースを想定する
  3. なお、リストの中には実在しない URL が存在している可能性がある(つまりリストそのものが間違っている可能性がある)
  4. また URL は実在しているのだが、ネットワーク障害や DNS の設定ミスなど何らかの原因でアクセスする際に非常に長い時間がかかる(長い時間がかかった結果、タイムアウトになったり成功したりする)場合もある

1と2はごく普通の条件ですよね。ここではインターネット上の URL のリストは配列変数で用意されているものとしましょう。配列から1つずつ URL を取り出して、その URL の HTML を取得する、という処理を施すことになります。

問題は3と4の条件です(でも現実的に想定すべき条件だと思ってます)。3は用意されたリストそのものが間違っているというケース、つまり与えられた URL は "Unknown Host" になったり、404 などのエラーが返ってくることを想定しないといけない、ということです。

また4は更にややこしい条件です。成功するかしないかではなく、こちらからは手が出せない箇所のなんらかの障害によって目的の URL へのアクセスに非常に時間がかかってしまうケースです。時間がかかった結果、目的の HTML が取得できればいいのですが、最終的にタイムアウトエラーが発生することもあり得る、というケースを想定する必要があります。


要するにこれらを想定したエラー対策が必要になるのですが、まずは3と4を無視して(エラーが発生しない前提で)普通にアルゴリズムを考えるとこんな感じになるでしょうか:
//. URL の配列
urls = [
  "http://xxx.com/a1.html",
  "https://xxx.com/a2.html",
  "https://yyy.net/",
  "http://abc.com/xyz.html",
     :
     :
];

//. URL を1つずつ取り出して HTML を取り出す
forall( url in urls ){
  html = getHTML( url );
      :
      :
  (取り出した HTML を使って学習処理を行う)
      :
      :
}


↑の例ですと、getHTML 関数の中で実際に指定した URL にアクセスして HTML を取り出す、という処理をするものとします。そしてこの関数の中で3や4を原因とするエラーや時間がかかるといった現象が発生することを想定してみます。

3のケースは実は単純で、実在しない URL が指定された場合はこの関数の返り値を null などにして、null でなかった場合のみ処理を続ける、という判断を加えることで解決します:
//. URL の配列
urls = [
  "http://xxx.com/a1.html",
  "https://xxx.com/a2.html",
  "https://yyy.net/",
  "http://abc.com/xyz.html",
     :
     :
];

//. URL を1つずつ取り出して HTML を取り出す
forall( url in urls ){
  html = getHTML( url );
  if( html != null ){ //. 3の対策
      :
      :
  (取り出した HTML を使って学習処理を行う)
      :
      :
  }
}


さて問題は 4 のケースです。3 のアルゴリズムを単純に(シーケンシャルに)実行した場合、特定の URL から HTML を取り出す処理に時間がかかってしまうような事態が発生すると、リストの途中で処理が先に進まなくなってしまう、ということになります。このようなケースを想定した上で効率よく処理を実行するにはどう改良すべきでしょうか?

1つの方法として考えたのが非同期処理です。上記のループ部分を非同期に処理して、リスト内の各 URL へのアクセスを非同期に行う、という方法です。アルゴリズムにするとこのような感じになるでしょうか:
//. URL の配列
urls = [
  "http://xxx.com/a1.html",
  "https://xxx.com/a2.html",
  "https://yyy.net/",
  "http://abc.com/xyz.html",
     :
     :
];

//. URL を1つずつ取り出して HTML を取り出す
forall( url in urls ){
  html = getHTML( url, function( err, html ){  //. getHTML を非同期に実行する
    if( err ){
      //. 3. のエラー処理
    }else{
//. 成功した場合
: : (取り出した HTML を使って学習処理を行う) : : } }); }
↑非同期ということで JavaScript っぽくしてみました

このように非同期に処理を行うことで、「各 URL の HTML を取得する」という命令を全て先に実行しておき、(成功にせよエラーにせよ)取得の処理が終わったらそれぞれの続きを行う、というロジックです。こうすることで 4 のような事態が発生しても、正常な URL に対する処理は邪魔されることなく先に終了し、時間のかかる処理だけが後から実行される、という一見きれいな形になります。

しかし、この方法にも問題点がありました。それは URL のリストが膨大だった場合です。上記のコードが非同期に実行されるとまず全て URL に対する HTML 取得のリクエストが発行されます。そしてその処理はシステムのメモリ量や TCP ソケット数上限を超えて実行されてしまう可能性があります。この部分はコーディングというよりもシステムのメモリ管理やソケット数管理などの厄介そうな処理を行う必要がでてきてしまいます。

で、冒頭のマルチスレッドです。上記の非同期で行っていた部分をマルチスレッドに書き換えることで、(スレッド生成間のスリープ時間を調整するなどの)ある程度のスケジュール調整をした上で同時に HTML を取得する処理を行うことができるようになります。例えばこんな感じです(ここは言語依存がありそうなので、Java 丸出しで記述しています):
//. URL の配列
urls = [
  "http://xxx.com/a1.html",
  "https://xxx.com/a2.html",
  "https://yyy.net/",
  "http://abc.com/xyz.html",
     :
     :
];

//. URL を1つずつ取り出して HTML を取り出す
forall( url in urls ){
  //. 子スレッドを生成して、スレッドの中で取得処理を実行
  Download dl = new Download( url );
  Thread t = new Thread( t );
  t.start();

  try{
    Thread.sleep( 1000 ); //. 1秒待ってから次の URL を処理
  }catch( Exception e ){
  }
}


//. マルチスレッドで動くインスタンス
public class Download implements Runnable{
  private String url = "";
  public Download( String url ){
    this.url = url;
  }

  public void run(){
    html = getHTML( url );
    if( html != null ){
      :
      :
  (取り出した HTML を使って学習処理を行う)
      :
      :
    }
  }
}

↑マルチスレッドなので Java 全開の記述法で

この方法であれば、各 URL に対する HTML の取得は別々のスレッドで行われるため、特定の URL で 4 のような遅延現象が発生しても、他の URL に対する処理がその遅延に巻き込まれることはありません。また、この例では1秒(1000ミリ秒)おきにスレッドを生成するようにしています。例えば1スレッドの処理が2秒程度かかるようなケースであっても、3つ目のスレッドが生成されたタイミングで最初のスレッドの処理は終了している可能性が高くなり、同時に実行されるスレッドの数がさほどは増えないようなアルゴリズムになっています。仮に 4 のようなケースが発生したとしても、そのスレッドだけはしばらくの間生き続けることになりますが、他のスレッドは生成しては処理されて消えてゆくという流れになるので、やはりシステムの限界を意識するような処理にはなりにくいアルゴリズムになっているのでした。


という所まで作っての「マルチスレッド処理が効率よい」という冒頭の結論に至ったわけでした。要するにこれなら深く考えずに作って動かしてもややこしい対応が必要になる心配が少ないかな、と。またマルチスレッド処理となると Java が得意とする処理ロジックであり、オッサン脳の出番が増えるかもしれないなあ、と感じたのでした。

このページのトップヘ