まだプログラマーですが何か?

プログラマーネタ中心。たまに作成したウェブサービス関連の話も https://twitter.com/dotnsf

2016/02

StrongLoopLoopBack を使うと、データベースのモデルを定義するだけで CRUD の REST API を生成し、OpenAPI(Swagger) スタイルのドキュメントと併せて簡単に公開できます。この辺りについては以前のブログエントリを参照してください:
CentOS に StrongLoop をインストールする


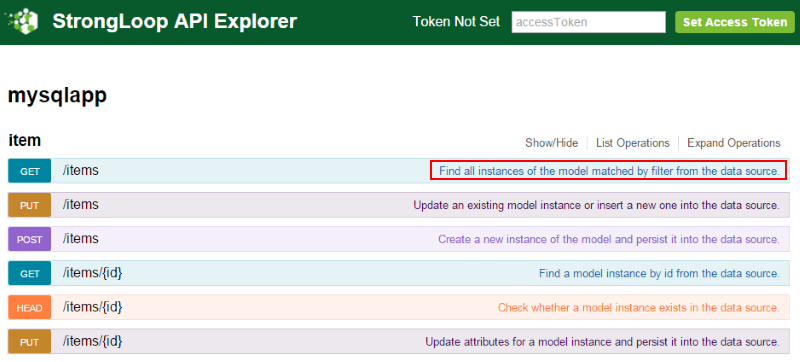
ところで、LoopBack を使って公開された API にはパラメータで挙動を指定できるものもあります。例えばモデルの一覧を取得する GET リクエストでは一覧を絞り込むためのクエリーを指定したり、取得結果の数やオフセットを指定することも可能です:
2016020601


そのための方法を紹介します。例えば items というテーブルに対して LoopBack で CRUD の API を作成したと仮定します。items の一覧を取得するには以下の様な URL に対する HTTP リクエストを GET で実行することになります(XX.XX.XX.XX は LoopBack が動いているサーバー):
http://XX.XX.XX.XX/api/items/

さて、一覧の検索条件(例えば id < 100)を指定する場合、SQL ではこのように指定することになります:
> select * from items where id < 100;

この条件を指定して上記の HTTP GET リクエストを実行するには、つまり id < 100 のものだけの一覧を API で取得するには、以下の様なパラメータを指定して実行します:
http://XX.XX.XX.XX/api/items?filter[where][id][lt]=100

filter という名前に [where] 句が指定され、更に条件である [id] が [lt] (Less Than) で 100 である、という条件が指定されていることになります。


一方、一覧の検索結果の取得数(例えば10件)を指定する場合、SQL(MySQL) ではこのように指定します:
> select * from items limit 10;

この条件を指定して HTTP GET リクエストを実行するには、以下の様なパラメータを指定して実行します:
http://XX.XX.XX.XX/api/items?filter[limit]=10

filter という名前に [limit] 句が指定され、その値が 10 である、という条件が指定されていることになります。なんとなくコツが分かってきましたか?

ちなみに一覧の検索結果の取得数を 50 件目からの 10 件、とするには SQL(MySQL) ではこのように指定します:
> select * from items limit 50, 10;

limit 句を指定し、オフセットが 0 以外の場合は limit 数の前にオフセット数を指定します。これを API のパラメータで指定するには以下のようにします:
http://XX.XX.XX.XX/api/items?filter[limit]=10&filter[offset]=50

クエリーや結果取得の条件は同時に指定することができます。例えば「 id < 100 のものをオフセット 50 で10 件取得」するのであれば、API ではこのように指定します:
http://XX.XX.XX.XX/api/items?filter[where][id][lt]=100&filter[limit]=10&filter[offset]=50

filter の使い方、なんとなくコツがわかってきましたか? 使っているデータベースの種類は何で、そのデータベースでは SQL ではどういった指定になるか、をイメージできるとわかりやすいです。


このパラメータに関する API ドキュメントはこちら:
https://docs.strongloop.com/display/public/LB/Where+filter
 

MySQL を使い始めた時にはあまり深く考えずにデフォルトインストールしてデフォルト設定で使い始めて、使っているうちにディスクが足りなくなってきた(或いは「このままだとディスクが足りなくなる」)という人向けの情報です。

要は MySQL の運用開始後に充分な容量を持つディスクドライブ(あるいはファイルシステム)にデータディレクトリを引越しする手順、の紹介です。OS は CentOS を前提とし、細かいコマンドは異なりますが、考え方は同じです。

データディレクトリを引っ越す場合、何はともあれ MySQL サーバーを停止します:
# service mysqld stop

次に my.cnf ファイル(CentOS であれば /etc/my.cnf)をテキストエディタで編集して、新しいデータディレクトリを指定します。データディレクトリは [mysqld] 内の datadir で指定します(この例では /var/lib/mysql をコメントして /data/mysql を指定しています):
[mysqld]
#datadir=/var/lib/mysql datadir=/data/mysql : :

そして、旧データディレクトリ(/var/lib/mysql)をオーナーやパーミッション等を保持したままディレクトリごと新データディレクトリ(/data/mysql)にコピーします:
# cd /data
# cp -r -p /var/lib/mysql ./

引越作業そのものはこれで完了です。止めていた MySQL サーバーを起動します:
# service mysqld start

確認のため管理者ユーザー(root)権限で MySQL サーバーにログインし、datadir 変数の値が新しいものに変わっていることを確認します:
# mysql -u root -p
  :
  :
mysql> show variables like 'datadir'; +---------------+--------------+ | Variable_name | Value | +---------------+--------------+ | datadir | /data/mysql/ | +---------------+--------------+ 1 row in set (0.00 sec)

ここまで確認できていれば、特に不要であれば旧データディレクトリは削除してもかまいません:
# rm -rf /var/lib/mysql

引越完了!
 

周囲の一部では「コンピュータに詳しい人」と認識いただいています。うれしいことです。


そんな自分がたまに受ける相談の1つがこういったものです:
- 「初心者向けでいいんだけどどんなパソコンがおすすめ?」
- 「初心者なんだけどどんなスマホがいい?」

以前の自分はこのような相談に対して、次のような質問をしていました:
 何に使うの?

要は利用用途を聞いて、それに合わせた安価なモデルを紹介しようと思っていたのでした。

そんな自分の質問への返答は、ほぼ 100% こんな感じでした:
- 「初心者だからメールとウェブ、あとオフィスが使えればいい」
- 「メールとツイッターと facebook と LINE と、、、そんなに使わないから安いのでいい」

ああ、そうなのね。じゃあそんなにスペック高くなくていいのか。。 だったらこの廉価版モデルでいいんじゃない? 的な感じでいくつか見つけて勧める、場合によっては自分が以前使っていて古くなったPC/スマホをあげる、というパターンで対応してました。

そして毎回のように後でトラブルに巻き込まれます:
- 「オフィスが(ワードとエクセルとパワポを同時に使ってたら)重くて使いものにならない」
- 「ゲームが重い」
- 「動画の編集が重い」
- 「なんか強制終了しちゃう」
- 「VMWare が重い」
- 「メモリが足りない、ディスクが足りない、・・」

ちょ、ちょっと待って。オフィスは同時機動しないで1ウィンドウずつ消して使えばいいじゃん。あとゲームとか動画編集とか、そんな用途に使うなんて聞いてないし。あと VMWare ってどこで覚えたんだよ?そうやって使うって聞いてたらもっと高いスペックのをおすすめしたんだけど・・・ あー、でもとりあえず応急処置が必要だよね。まずはディスクのクリーンアップをした方がいいよ。え、「何それ?」って何それ・・


そして分かったこと。こんな相談を受けた時に『何に使うの?』なんて聞いちゃいけないってこと。聞いても相手は自分が何に使うのか分かってないことが多い。最近のゲームが結構高いスペックが要求されていることも知らないし、質問の答が返ってきても、それは「初心者と自覚してる人の答」。正しく認識している可能性は低いし、こちらもその認識を頼りに選んじゃうから後で困る。

今の自分ならこう答えます:
 高い奴を買おう

何に使うか分かってないのなら、何にでも使えるように高いモデルを買っておいたほうがいい。安心料込み、だと考えてもいいと思います。高いのがたくさんあって迷うのであれば、とりあえずは「メモリを多く搭載しているやつ」。iPhone とかもその典型だと思います。メモリが足りなくなった場合の対処って(特に初心者には)結構難しい。ヘビーな使い方をするかどうかはともかく、長く現役でいられるという意味でもハイスペックマシンは初心者向けだと思ってます。

#加えて、PCであればデスクトップよりもノートを買うべきです。理由は困ったときに「詳しい人に家に来てもらう」ことなく「詳しい人に直接診てもらう」ことができるからです。


逆にミドル/ロースペック機はどんな人に向いているかというと機能が低いことを理解した上で困らない程度に使う、ということができる人あることをやろうとしてスペックが足りなかった場合にそれを理解した上で諦める、という使い方ができる人です。これらはそれなりに知識がないとできないことだからです。逆に初心者が制約事項を多く受けながら使い続けることのほうが難しいので、その障壁を少しでも低く設定する意味でもハイスペック機は有効です。

#スマホの場合はミドルスペックだと省電力仕様になっていることが多いので「電池を長く持たせたい人向け」という考え方もできると考えてます。ただ省電力であることを理解して使え、というのも初心者には難しい話だとも思っています。


というわけで、今の自分の考え方では「初心者こそ高いスペックの機種を使うべき」だと思ってます。違う意見を持つ人もいると思いますが、こんな考え方をしてる人もいる、ということで。


先日、このブログで CentOS に PostgreSQL サーバー環境を構築する手順を紹介しました:
CentOS に PostgreSQL 9 をインストール&利用する

今回はクライアント側の基本コマンドを中心に紹介します。まずはリモートサーバーへの接続コマンドです:
$ psql -h (hostname) -U (username) -d (database)
ユーザ (username) のパスワード: (password)
  :
  :
(database)=> 

何もオプションを指定せずに psql コマンドを実行すると、localhost の、ログイン中のユーザー名で、ユーザー名と同じ名前のデータベースに接続します。リモートサーバーへ接続する場合は上記のように -h オプションで、そしてユーザー名とデータベース名はそれぞれ -U / -d オプションで指定して接続します。

また、接続後によく使う(SQL 以外の)コマンドをまとめておきます。比較の意味で、MySQL でのコマンドを横に記述しておきます:
コマンド説明MySQL でのコマンド
\lデータベース一覧show databases
\dテーブル一覧show tables
\d テーブル名テーブルの定義確認desc テーブル名
\i SQLファイル名SQL ファイルの実行source SQLファイル名
\q終了quit


これでリモートの PostgreSQL サーバーにリモートアクセスして、ログインして、中身を確認する、といった一連の作業ができるようになるかな。

今の会社に転職して丸1年経ちました。今日からは2年生です:
ibm1
 

入る前は「あれもやりたい」「これもやらないといけない」と偉そうに計画めいたことも考えていました。それらの一部はできたし、できなかったこともあったりするのですが、実際は当時思いもよらない程の物量で自分が学ぶことが多かった一年でした。そのおかげもあって、1年前の自分にはなかったスキルや知識、経験を経て、大きく成長することが出来たと思っています。また想定をはるかに上回るペースで色々な人と出会うことのできた一年間だったと感じています。

自分に近い人は知っていることですが、自分は今の会社に入ったのは2度めです。要するに「一度自分の意志で出て行った」所に「ノコノコ戻ってきた」わけです。この会社は復帰組も比較的多くいる方だと思います。ただ自分でいうのもなんですが、(管理職ではない、という意味で)平社員として戻ってきた例を個人的には知りません。
 
当時と所属部署や職種は異なりますが、当時の仲間やお客様と仕事を通じて出会うことも珍しくなく、「何か言われたりするかな?」と思ったりすることもあります。が、今の所みなさん好意的に受け止めてくれる人が多く、本当に嬉しいです。それどころか自分はこの復帰の経緯をアイスブレイクの鉄板ネタにしてたりします(笑)。1年経ってそれくらいの余裕が出てきました。

ちなみに再入社の前は、今の会社から見たビジネスパートナー的な立場にいました。今の会社の中で比較的偉い人とフランクな感じで(相手からは敬語で)話す ような機会も多かったのですが、ある日を境にその人達の会社に、その人達よりも下の立場で入社することになったのです。そして社内で再会、さあどうなる!?と思っていたら、相変わらず自分に対して敬語で話してかけてくれます(笑)。い、いや、あの、自分ペーペーなんで、、、 (^^;


・・・そんなペーペーも今日から2年目です。いっちょまえに新しくチームに入った人を指導する立場にもなりました。この1年は社内外に IBM Bluemix のエバンジェリスト的な人を、昨年以上に多く増やしていこう、そしてコードをかける人の地位が今よりももっと向上できるような活動に携わっていきたいと思っています。


というわけで、新しい一年もお手柔らかに、よろしくお願いします。

このページのトップヘ